当前状态:
, 最新更新时间: ,
doi: 10.11999/JEIT260365
摘要:
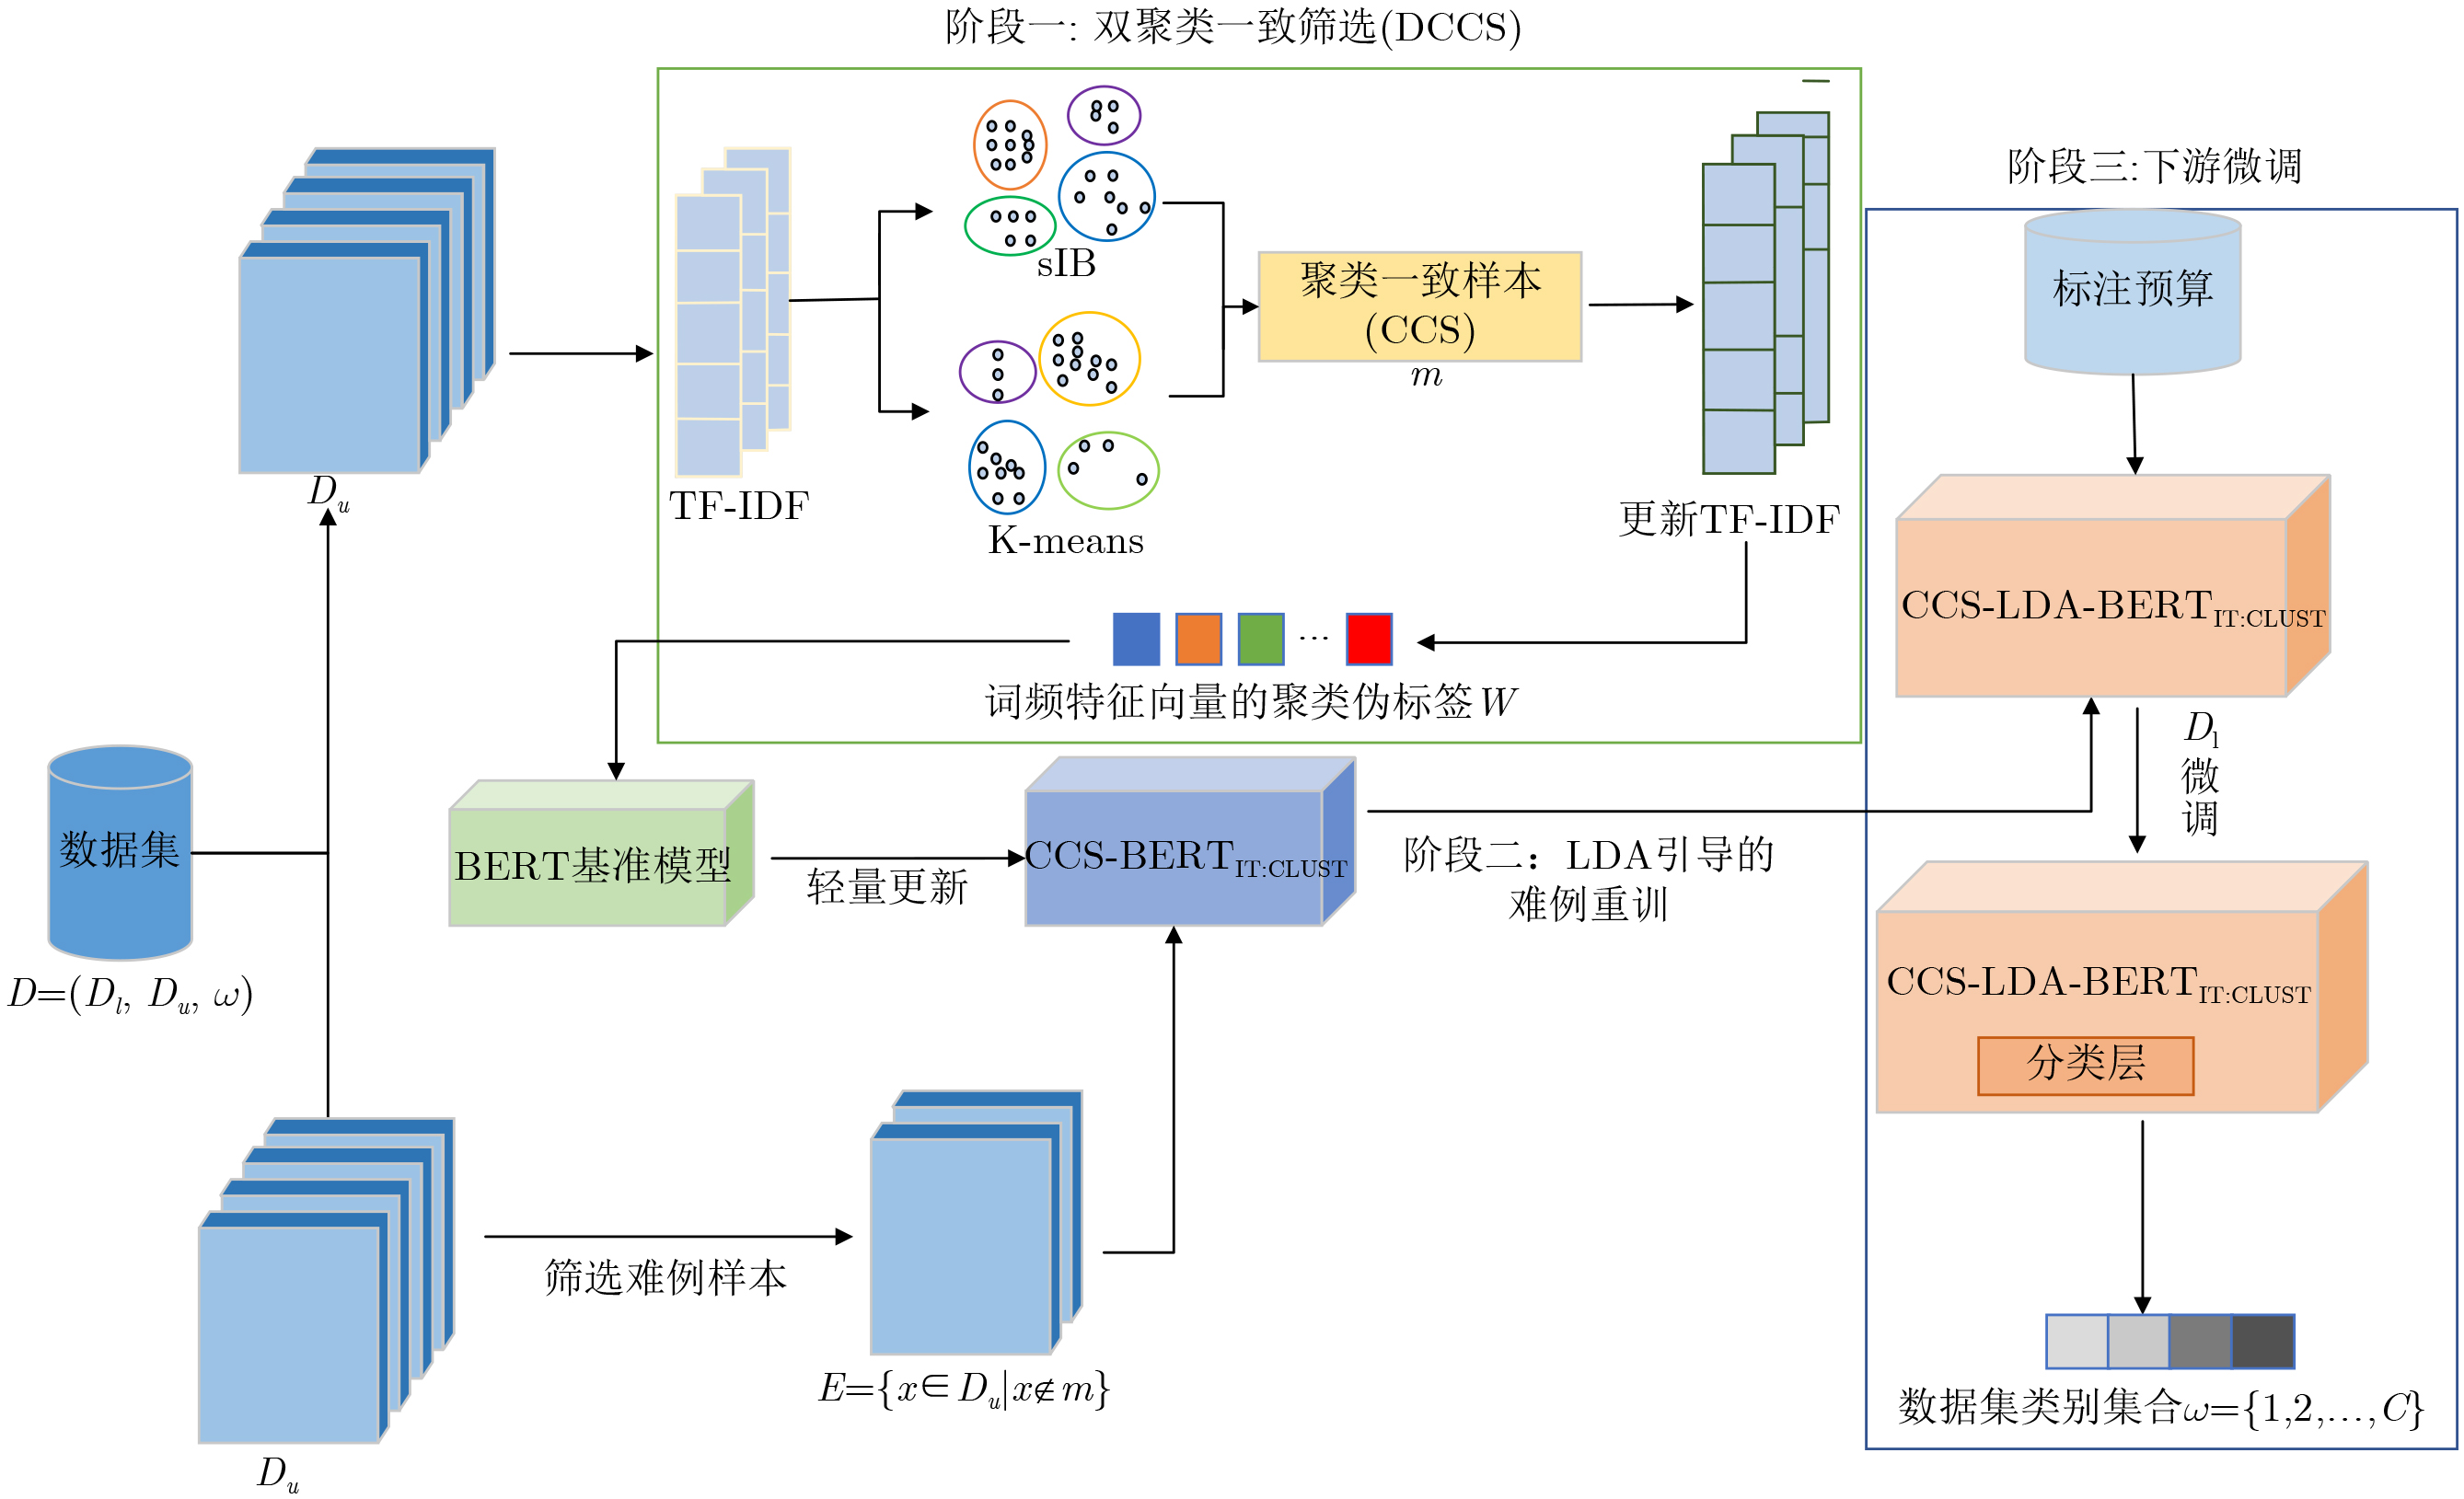
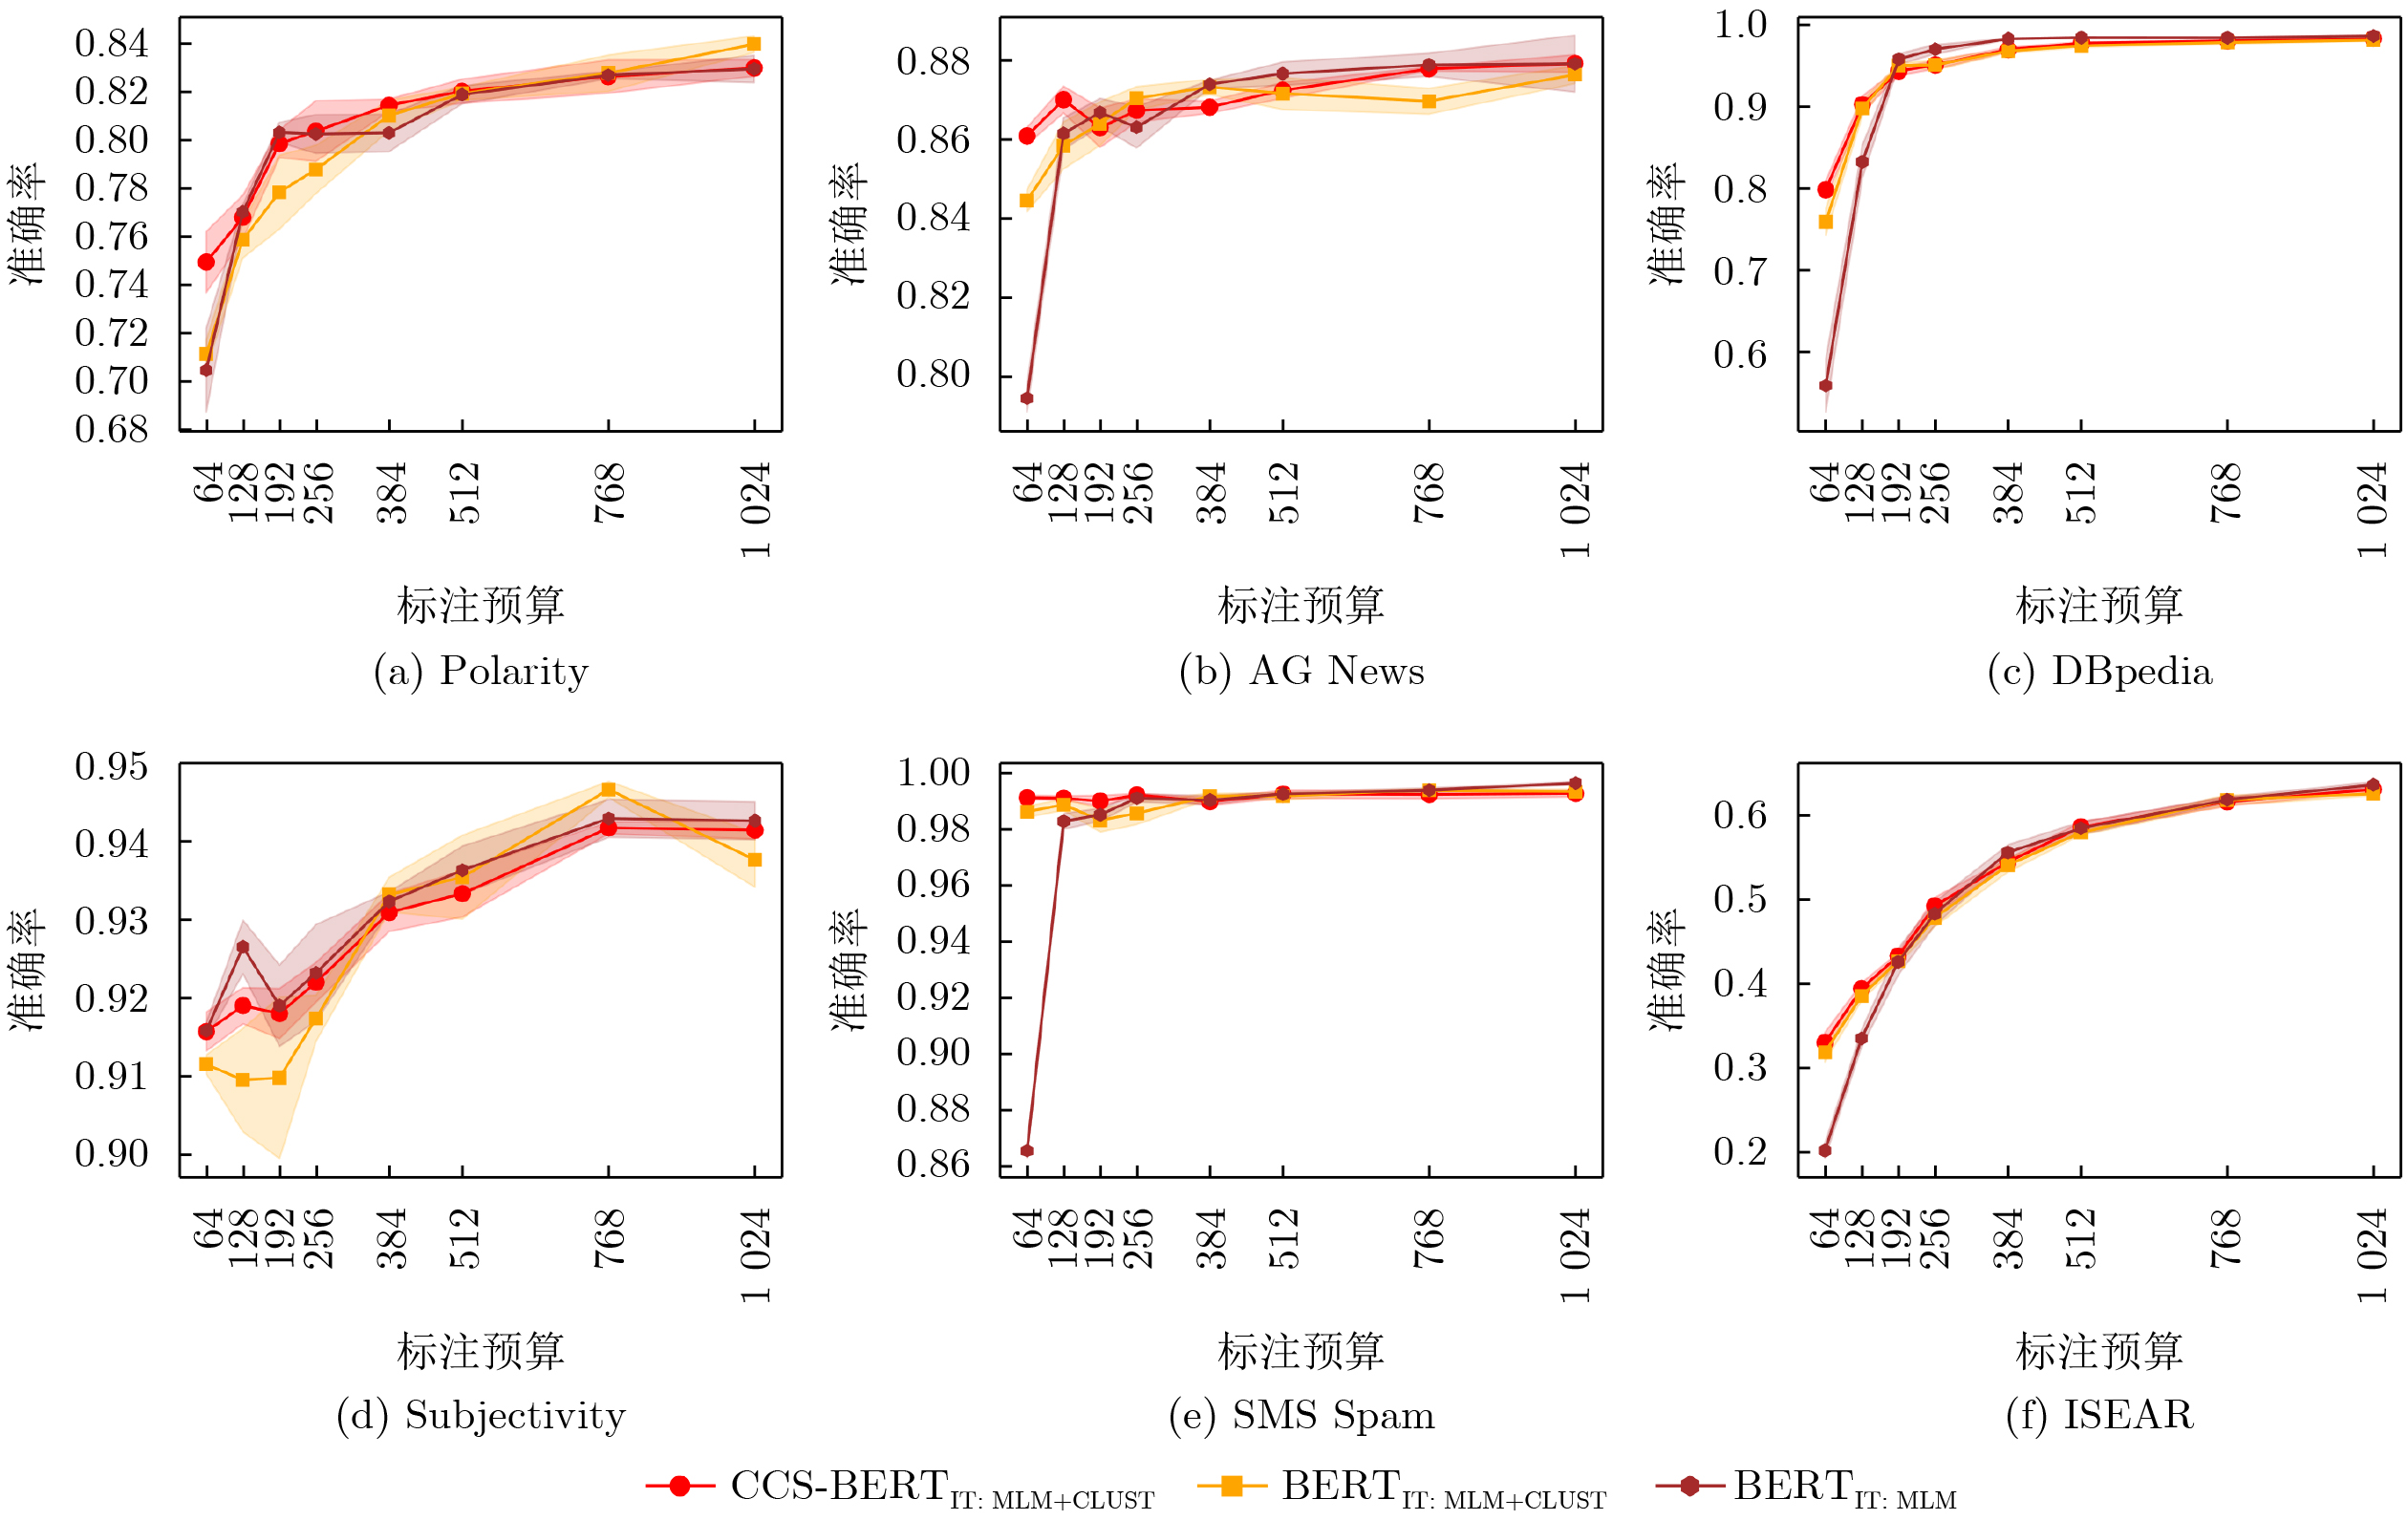
现有文本分类模型在标注数据稀缺场景下性能受限,其训练过程通常依赖单一视图的弱监督学习,易受噪声干扰,且难以挖掘难例样本在其他视图中的潜在判别信息。为解决上述问题,该文提出一种基于异构多视图语义融合的文本分类模型训练方法(HMVSF)。首先,在词频视图以双聚类一致性构建聚类一致样本集并进行一次轻量更新,提升伪监督可靠性;其次,开展主题建模,自适应选择主题数,生成硬标签与软分布,引导一次难例重训以充分挖掘其主题视图潜在特征;最后,两阶段共享同一编码器,在小规模标注集上统一微调,形成不依赖于特定的预训练起点的训练流程。在DBpedia, AG News, ISEAR, SMS Spam, Subjectivity, Polarity共6个公开数据集上,基于BERT分别设置两条初始化实验路线,实验结果表明,HMVSF整体优于代表性基线与单阶段变体,低标注预算下的提升尤为显著。