

An Energy-Efficient Accelerator Design for Fully Integer Vision Transformer Inference
-
摘要: Transformer网络在计算机视觉任务中展现出优异性能,但其端到端硬件部署仍受到量化再缩放和复杂非线性函数计算开销的限制。针对视觉Transformer中量化缩放因子处理复杂、层归一化(LN)、Softmax和高斯误差线性单元(GELU)等非线性函数硬件实现开销大的问题,本文提出一种基于非线性算子全整数计算的高能效视觉Transformer加速器。首先,采用尾数-指数(ME)再量化策略,将量化缩放因子表示为整数尾数与指数形式,通过少量整数乘法与移位操作实现片上数据对齐与再量化。其次,基于尾数-指数再量化计算模式和轻量化查找表,构建多种非线性函数的全整数计算方法,将除法、指数、平方根和倒数等复杂运算转换为整数乘法、移位和查表操作。进一步地,设计复用型非线性计算模块,实现片上缓存、乘移单元、ME域转换和查找表等底层资源共享。实验结果表明,在无需重训练或微调的情况下,所提出全整数计算方法相较量化基线的精度损失控制在 1% 以内。基于 28 nm工艺的ASIC综合结果显示,该加速器在500 MHz下实现
1024 GOPS峰值吞吐量,能耗效率达到3.26 TOPS/W,面积效率达到332.47 GOPS/mm2。-
关键词:
- Transformer /
- 硬件加速器 /
- 近似计算 /
- 非线性函数 /
- 软硬件协同设计
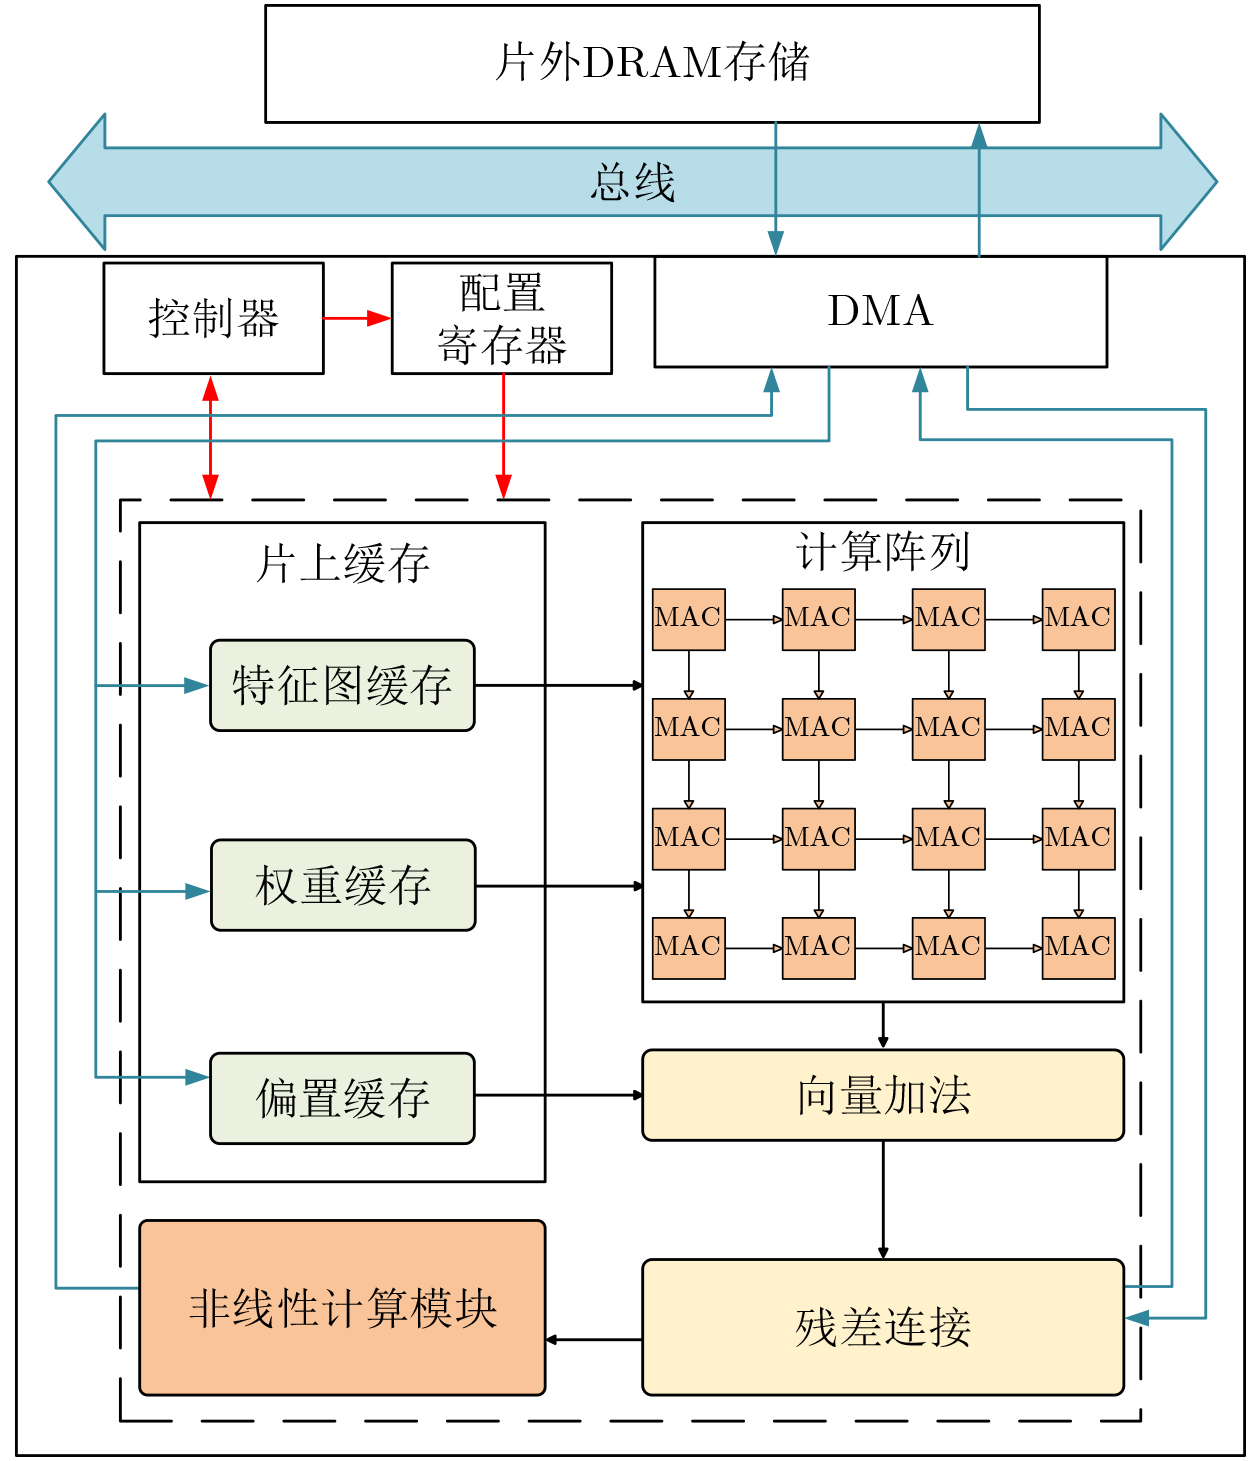
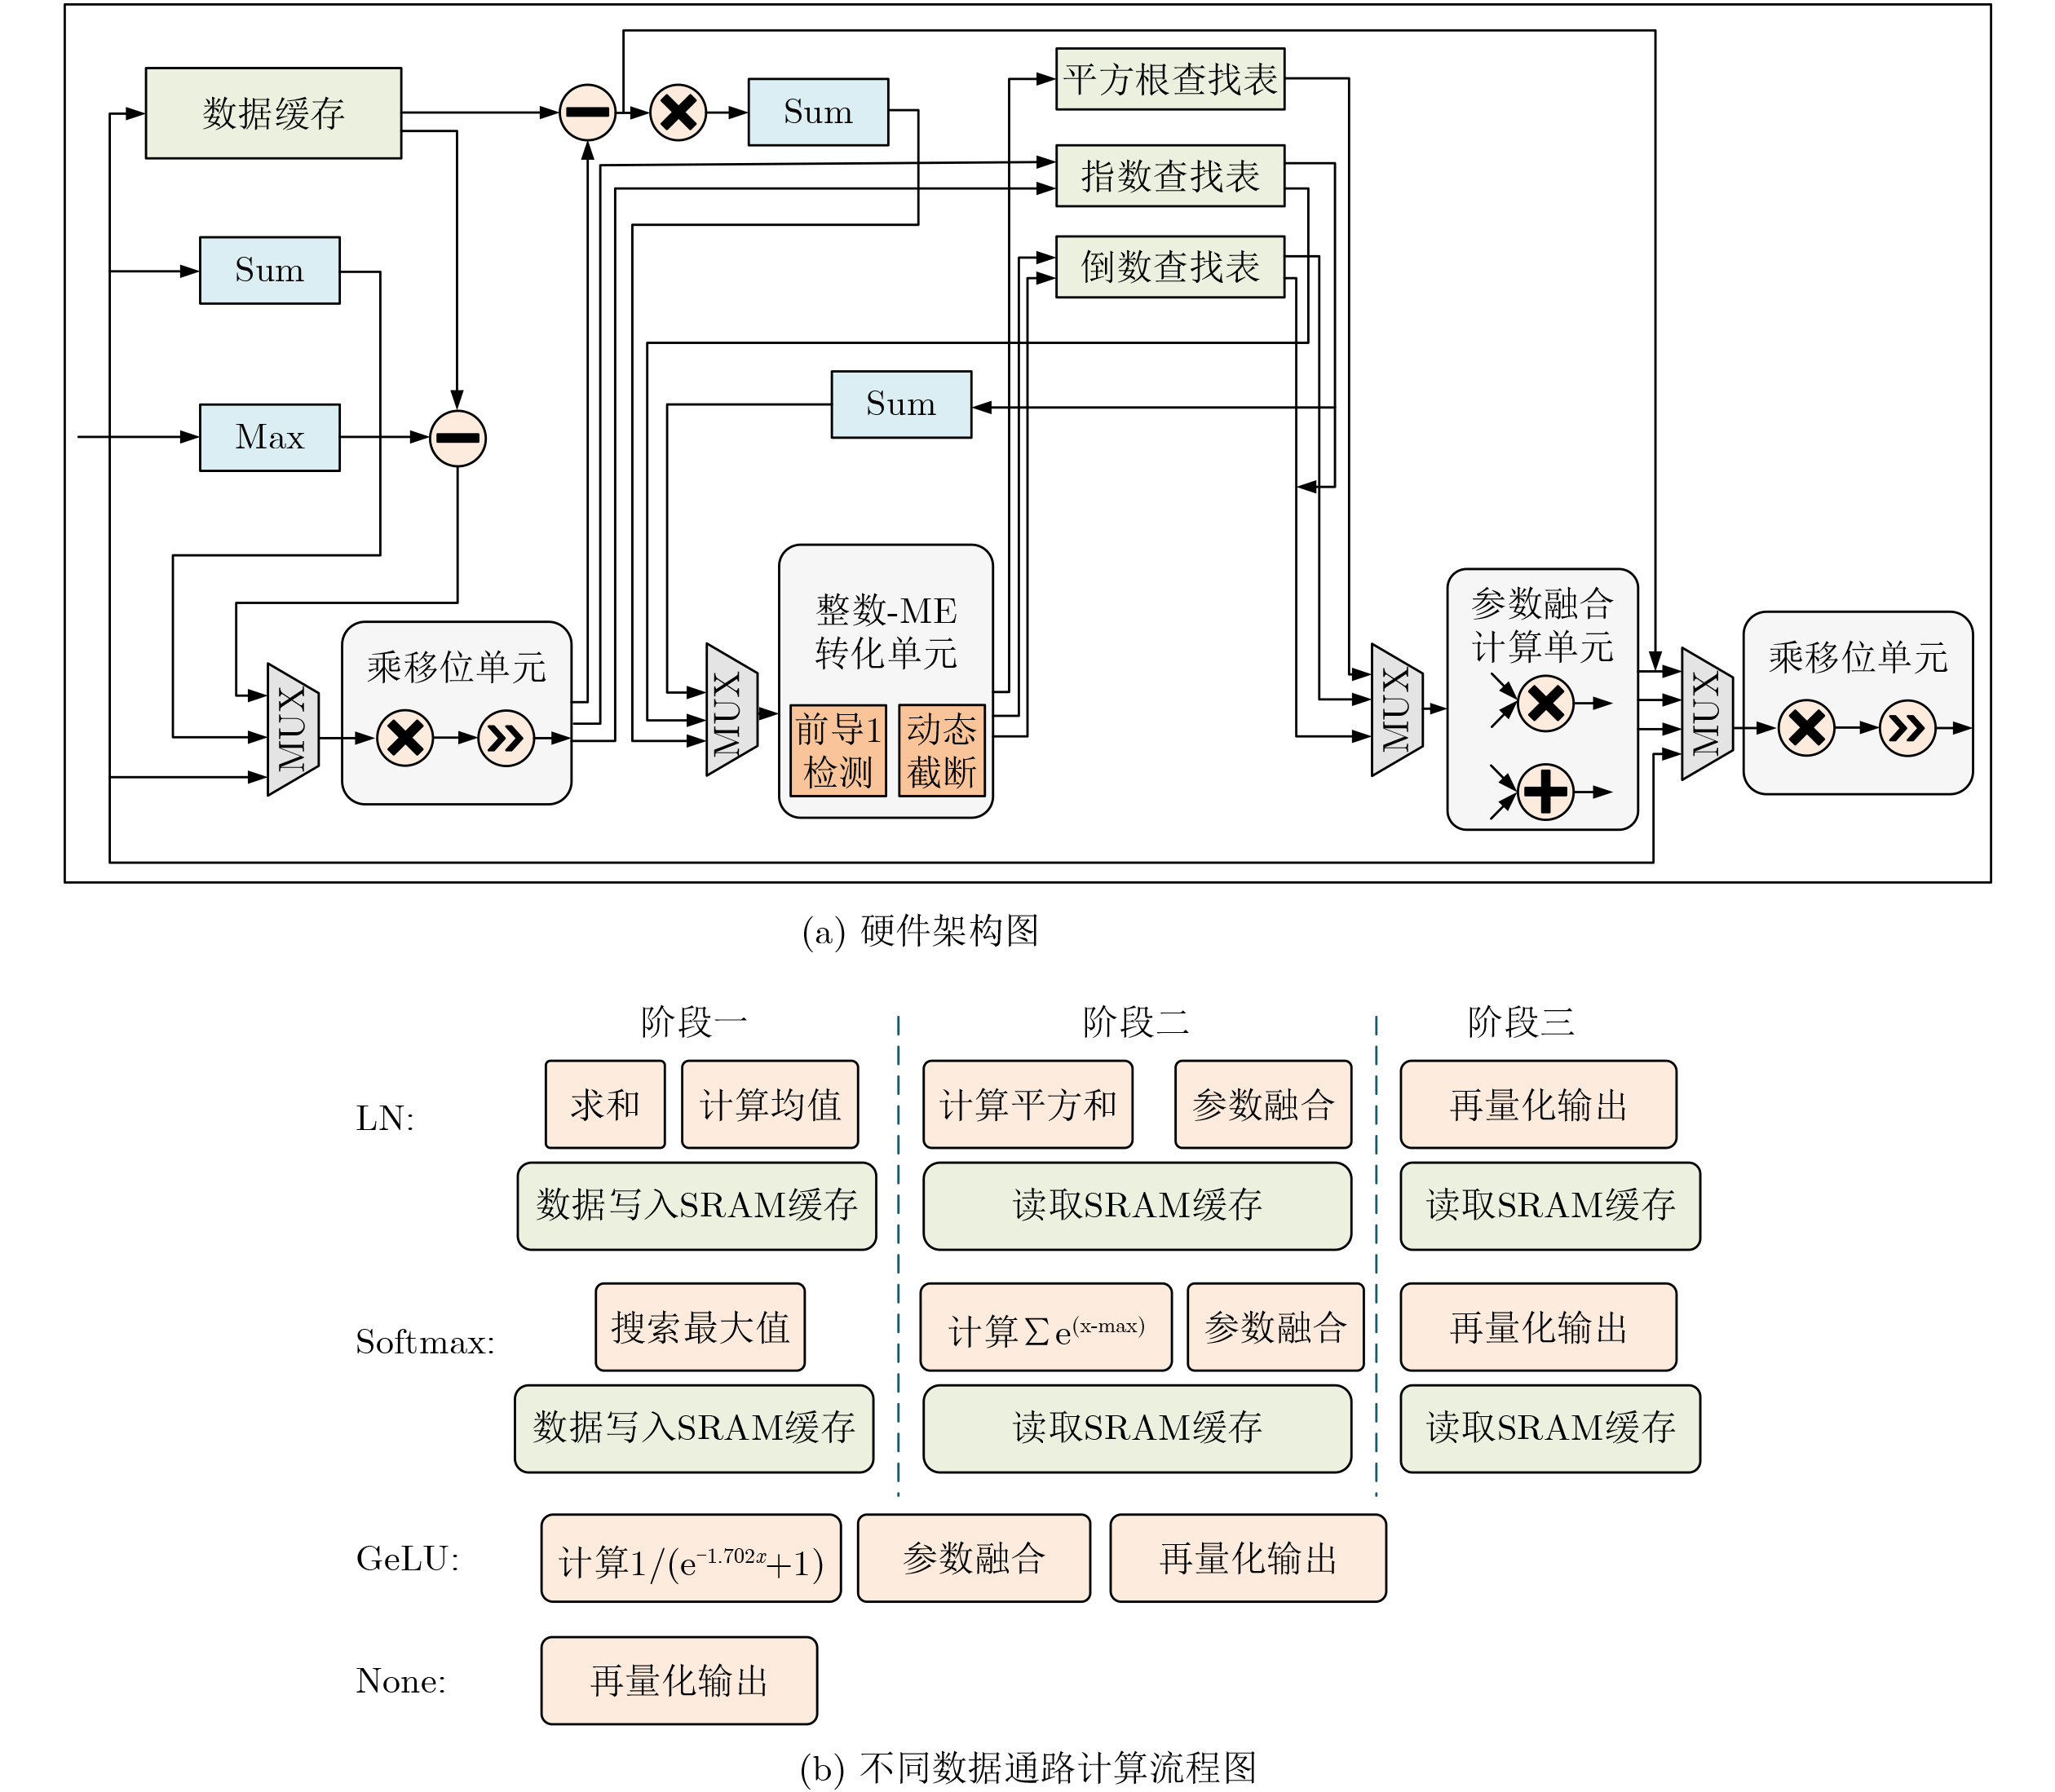
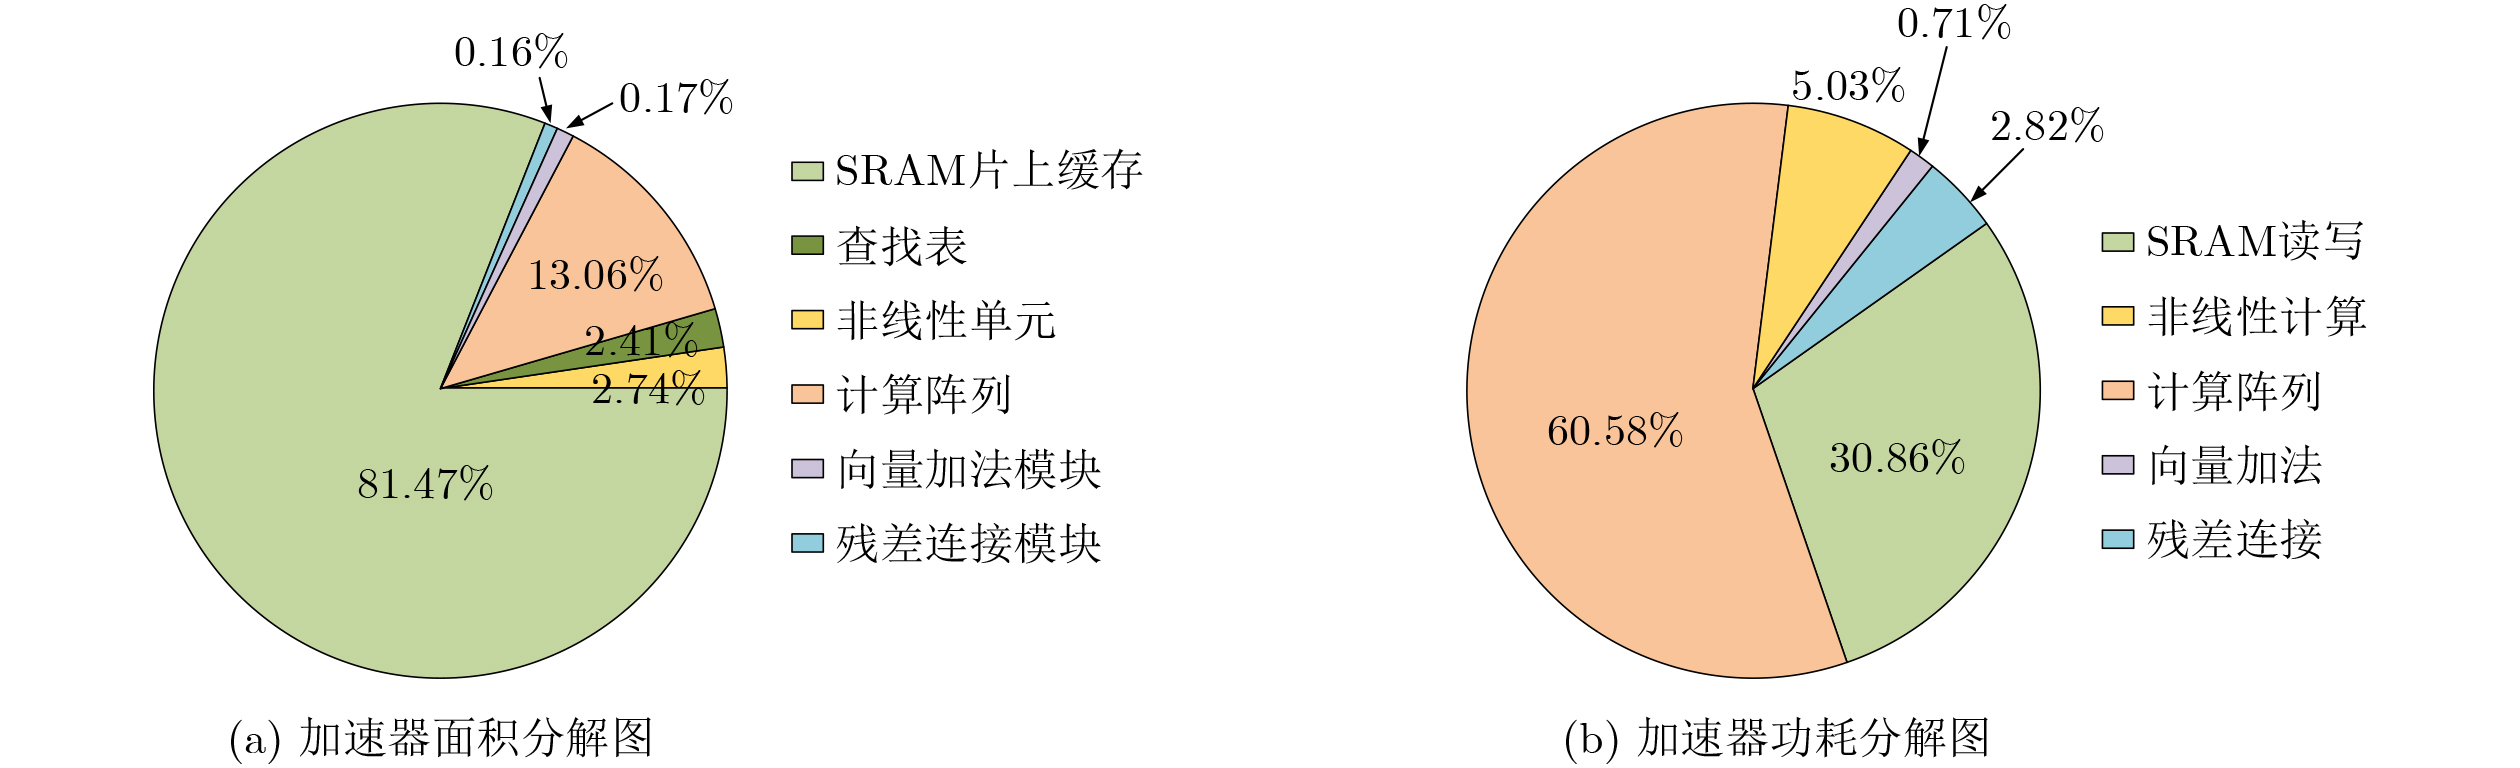
Abstract:Objective Vision Transformers (ViTs) have demonstrated exceptional performance in complex computer vision tasks, driving the continuous introduction of novel Transformer-based architectures, such as DeiT and Swin Transformer, into the field. However, the hardware deployment of Transformer models on edge devices is severely hindered by their massive parameter volumes and three key non-linear functions (LayerNorm, Softmax, and GELU), which entail complex mathematical operations such as reciprocals, square roots, and exponentials. Traditional compression schemes attempt to maintain algorithmic accuracy by designing complex quantization factors or employing quantization-aware training (QAT) and fine-tuning strategies, which inevitably introduce substantial computational overhead. Furthermore, existing hardware acceleration designs for these non-linear functions frequently retain power-hungry floating-point arithmetic or rely on complex iterative and piecewise linear logic, fundamentally limiting hardware energy efficiency. To overcome these limitations, this paper proposes a hardware-algorithm co-designed accelerator architecture tailored for the all-integer inference of Vision Transformers. At the software level, we introduce a unified all-integer approximation method for the computation of the non-linear functions and the subsequent requantization of layer outputs, completely eliminating hardware-unfriendly operations. At the hardware level, a dedicated non-linear computing module supporting multi-operator reuse is proposed to enhance hardware utilization. Through this deep hardware-algorithm synergy, the proposed design aims to boost hardware inference efficiency while preserving algorithmic accuracy. Methods This study first employs a Post-Training Quantization (PTQ) strategy to compress the ViT model, converting the quantization factors into a Mantissa-Exponent (ME) representation. This enables on-chip requantization alignment across layers through low-overhead multiplication and bit-shift operations. For the three critical non-linear functions—Layer Normalization, Softmax, and GELU—this paper extends the ME computational scheme. By incorporating lightweight Look-Up Tables (LUTs), computationally expensive division, exponential, and square root calculations are transformed into hardware-friendly integer multiplications, bit-shifts, and table lookups. At the hardware level, a ViT accelerator architecture supporting end-to-end on-chip inference is proposed ( Fig. 2 ). To mitigate off-chip memory access overhead, this architecture adopts a hybrid dataflow strategy combining Input-Stationary (IS) and Output-Stationary (OS) schemes. Furthermore, by mathematically unfolding the all-integer inference processes of the three non-linear operators, we extract their common underlying arithmetic operations and design a highly reusable non-linear computing module (Fig. 3 ). By extensively reusing LUT resources and fundamental computing units, this module efficiently executes the all-integer inference of the aforementioned complex non-linear operators, thereby significantly enhancing the area utilization of the overall hardware architecture.Results and Discussions To evaluate the proposed all-integer inference method for the three non-linear operators, this study assesses the accuracy using the ViT model on the ImageNet-2012 dataset. In this setup, the weights and activations of all layers are quantized to INT8, and the mantissa-exponent parameters involved in both the non-linear operations and requantization alignment are uniformly configured with 8 bit data. Experimental results demonstrate that, relative to the baseline with quantized linear layers, the additional accuracy degradation introduced by the all-integer approximation method for the three non-linear functions is strictly limited to less than 1% ( Table 2 ). This indicates that the proposed method effectively maintains algorithmic accuracy while thoroughly eliminating the overhead associated with floating-point arithmetic and division operations. To further evaluate the proposed hardware accelerator architecture, we performed an ASIC implementation and conducted synthesis and simulation using Synopsys Design Compiler (DC) at a clock frequency of 500 MHz. The proposed accelerator achieves a peak throughput of1024 GOPS, consumes 314.5 mW of power, and occupies a compact area of only 3.08 mm2. Notably, the proposed non-linear computing module supporting multi-operator reuse accounts for merely 7.28% of the power consumption and 16.99% of the area of the overall on-chip computing logic (Fig. 4 ). By successfully circumventing the massive overhead caused by complex mathematical operations, such as reciprocals and square roots, and dynamic sparse control logic, our pure-integer, static-pipeline architecture achieves a remarkable energy efficiency of 3.26 TOPS/W and an area efficiency of 332.47 GOPS/mm2 (Table 3 ), demonstrating prominent advantages over existing state-of-the-art accelerators.Conclusions To address the deployment bottlenecks of Vision Transformer (ViT) models on edge hardware, specifically those imposed by requantization factor processing and complex non-linear function computations, this paper proposes a hardware-algorithm co-designed accelerator architecture tailored for all-integer inference. At the algorithmic level, by employing arithmetic multiplications, bit-shifts, and table-lookups, the proposed method thoroughly eliminates hardware-intensive operations, such as divisions and square roots, within LayerNorm, Softmax, and GELU. This effectively achieves the all-integer inference of these three non-linear functions alongside end-to-end on-chip requantization alignment. At the hardware level, the area efficiency of the accelerator architecture is significantly enhanced through the deep reuse of the underlying computational units across the three operators. Experimental results demonstrate that the proposed all-integer approximation method incurs minimal accuracy degradation without necessitating costly model retraining overhead. Operating at a frequency of 500 MHz, the proposed hardware accelerator delivers a peak throughput of 1024 GOPS. With a remarkable energy efficiency of 3.26 TOPS/W and an area efficiency of 332.47 GOPS/mm2, the design exhibits competitive performance compared to existing state-of-the-art Transformer hardware solutions, thereby providing a robust and practical solution for the edge-based all-integer inference of ViT models. -
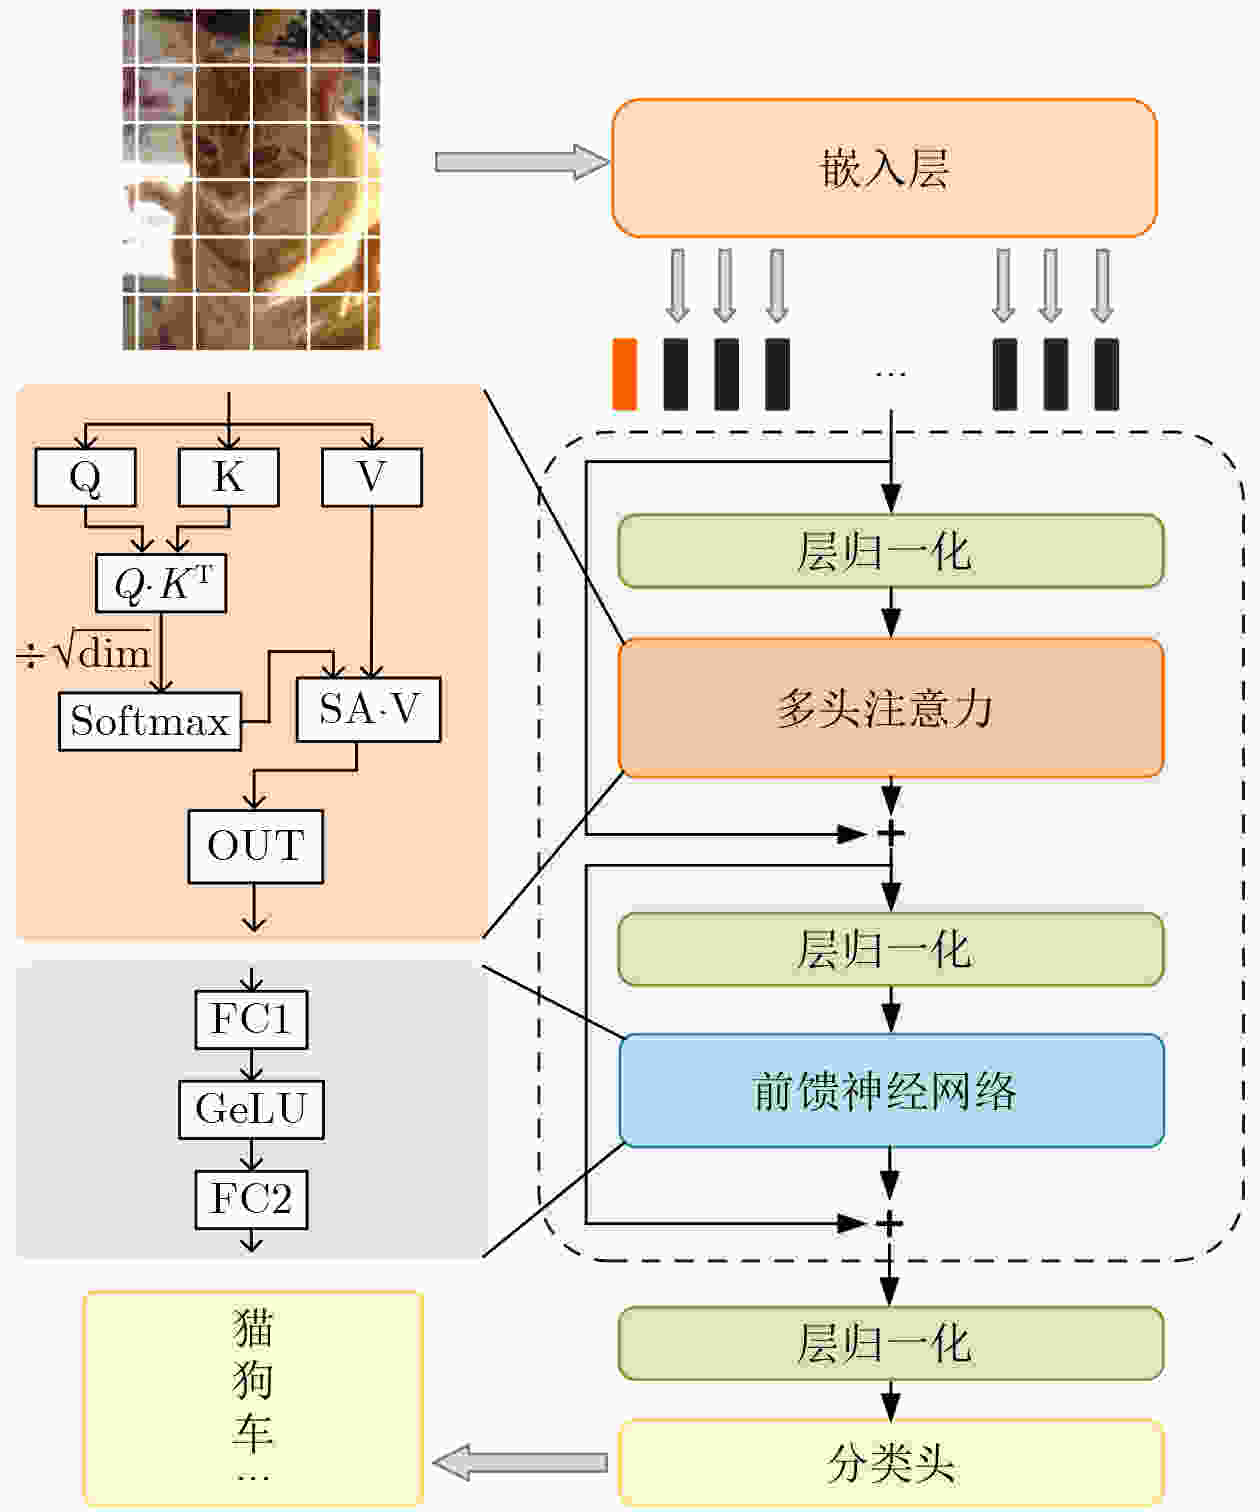
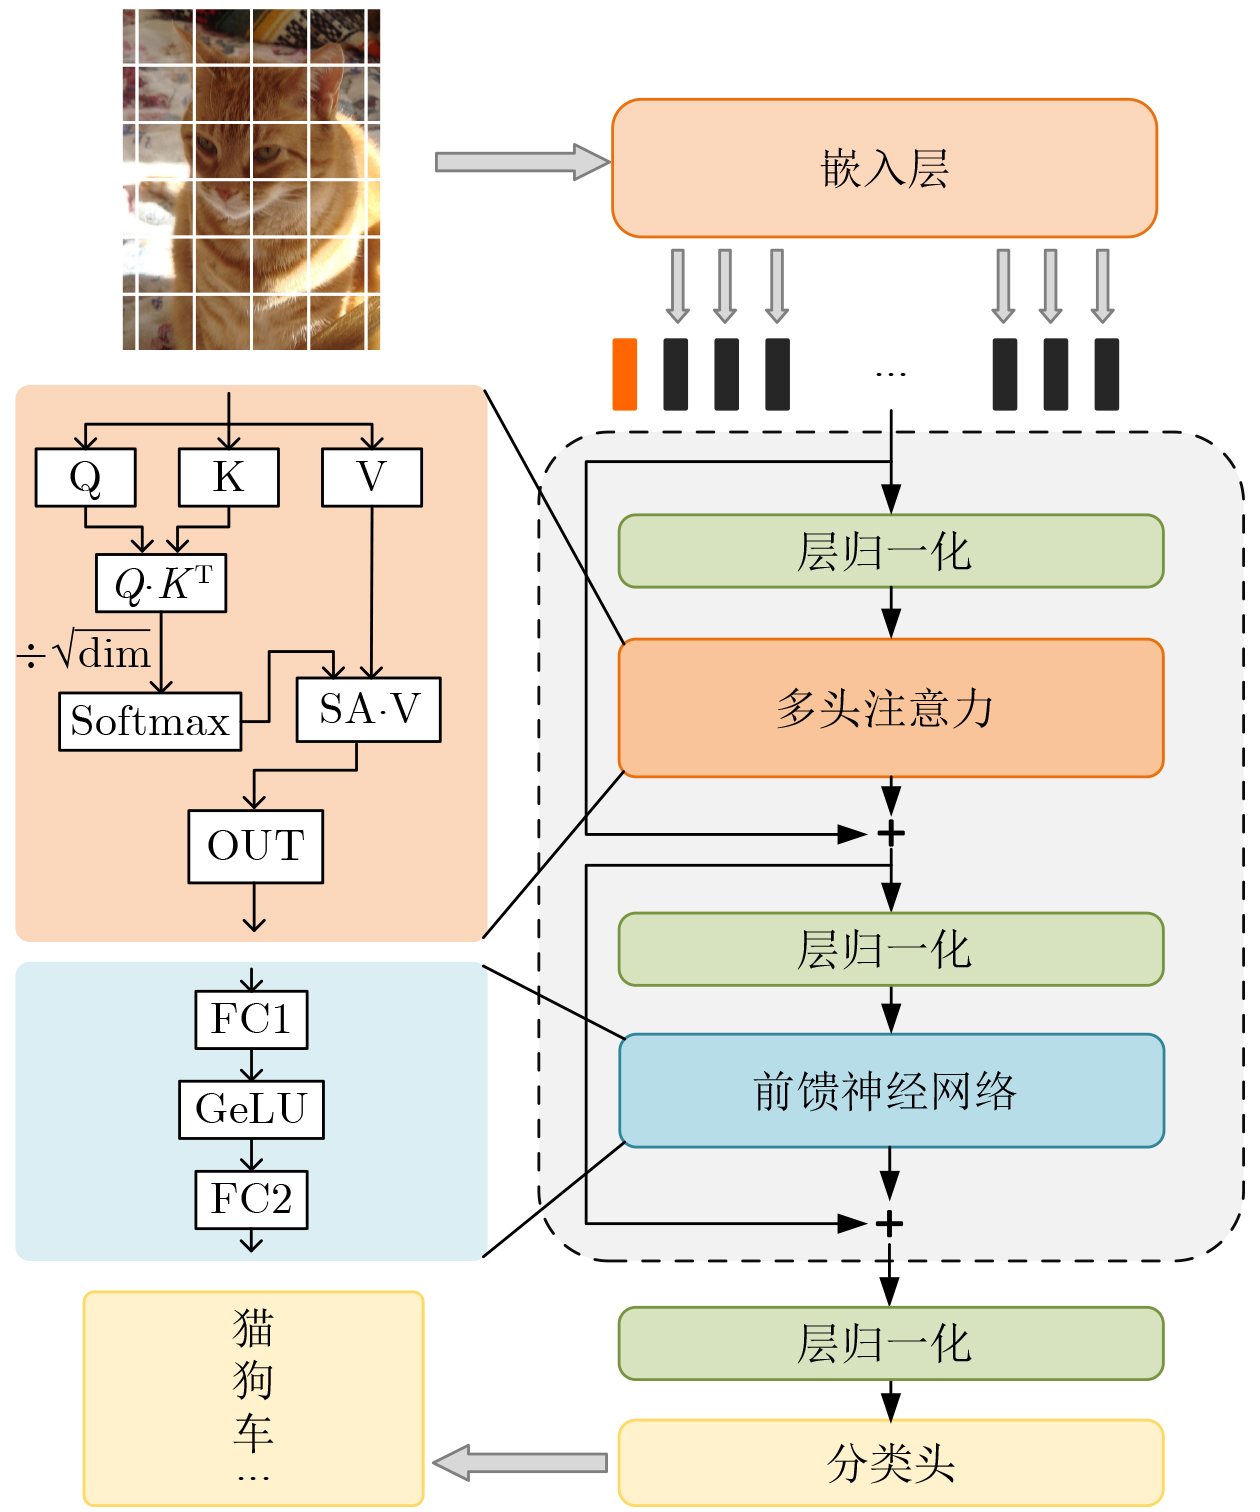
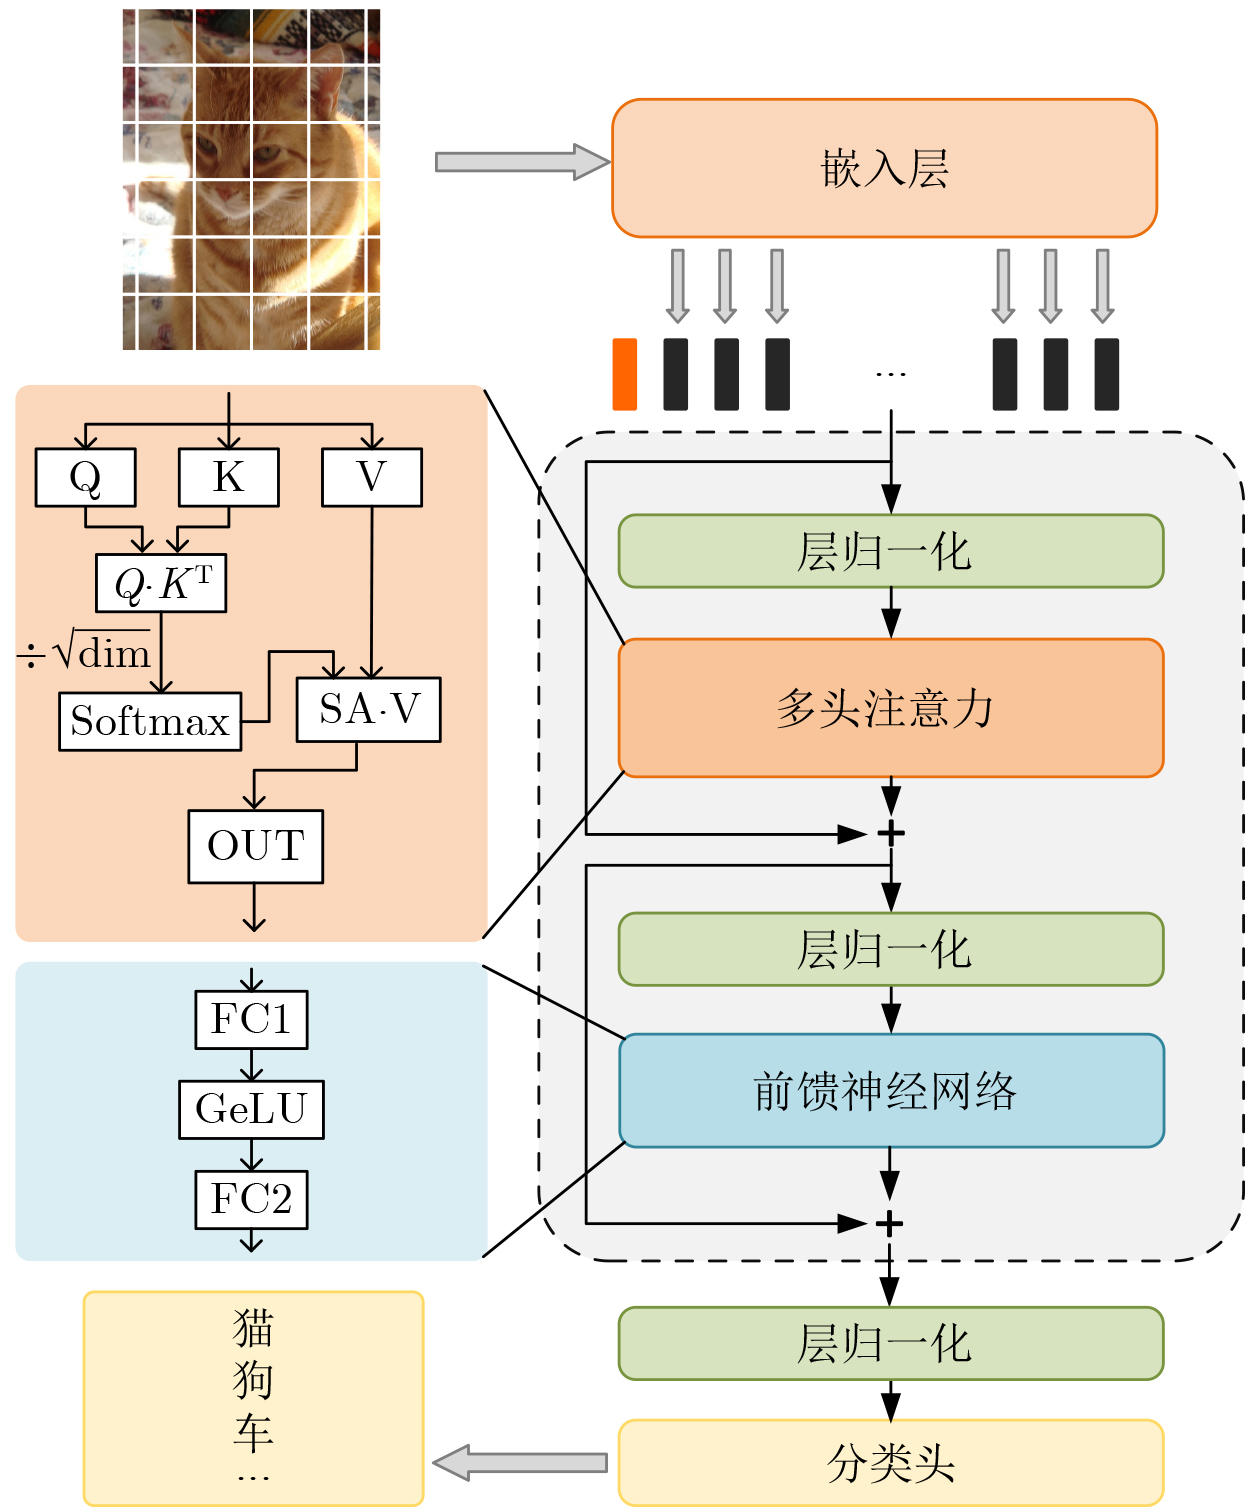
图 1 视觉Transformer示意图,其中Q、K、V分别代表查询(Query)、键(Key)以及值(Value)矩阵;SA代表自注意力(Self-Attention)分数;FC代表全连接层(Fully Connected)
1 全整数LayerNorm
输入:$ {\boldsymbol{x}}_{\text{in}} $:整数输入数据 $ {M}_{\text{in}} $、$ {E}_{\text{in}} $:均值计算参数,值为$ \mathrm{float}\_ \mathrm{to}\_ \text{ME}(1/\mathrm{dim}) $ $ {M}_{\text{out}} $、$ {E}_{\text{out}} $:再量化因子,值为$ \text{float}\_\text{to}\_\text{ME(}\sqrt{\dim }/{S}_{\text{out}}) $ 输出:$ {\boldsymbol{x}}_{\text{out}} $:LayerNorm的整数输出结果 计算过程:$ \text{LN}\left(\boldsymbol{x}\right)=\frac{\boldsymbol{x}-\mu }{\sqrt{\displaystyle\sum{\left(\boldsymbol{x}-\mu \right)}^{2}}}\times \sqrt{\dim }/{S}_{\text{out}} $ (1) $ \mu =\left({M}_{\text{in}}\times \displaystyle\sum\boldsymbol{x}\right)\ll {E}_{\text{in}} $ (2) $ {\boldsymbol{x}}_{\text{c}}=\boldsymbol{x}-\mu $ (3) $ {M}_{\text{sum}},{E}_{\text{sum}}\text{=int}\_\text{to}\_\text{ME(}\displaystyle\sum{\left(\boldsymbol{x}-\mu \right)}^{2}) $ (4) $ \text{idx=}{\{E}_{\text{sum}}[0],{M}_{\text{sum}}\text{[W-2:0]\}, W}\text{为尾数}{M}_{\text{sum}}\text{的位宽} $ (5) $ \frac{1}{\sqrt{\displaystyle\sum{\left(\boldsymbol{x}-\mu \right)}^{2}}}=\frac{1}{\sqrt{{M}_{\text{sum}}\times {2}^{{{E}_{\text{sum}}}\%2}}}\times {2}^{-\left\lfloor \frac{{E}_{\text{sum}}}{2}\right\rfloor }$
$=M_{\text{isqrt}\_\text{lut}}^{\text{idx}}\times {2}^{{E_{\text{isqrt}\_\text{lut}}^{\text{idx}}}-\left\lfloor \frac{{E}_{\text{sum}}}{2}\right\rfloor } $(6) $ {M}_{\text{final}},{E}_{\text{final}}\text{=fuse}\_\text{ME(}M_{\text{isqrt}\_\text{lut}}^{\text{idx}},E_{\text{isqrt}\_\text{lut}}^{\text{idx}}-\left\lfloor \frac{{E}_{\text{sum}}}{2}\right\rfloor , $
${M}_{\text{out}},{E}_{\text{out}}) $(7) $ {\boldsymbol{x}}_{\text{out}}=\left({\boldsymbol{x}}_{\text{c}}\times {M}_{\text{final}}\right)\ll {E}_{\text{final}} $  下载: 导出CSV
2 全整数Softmax
输入:$ {\boldsymbol{x}}_{\text{in}} $:整数输入数据 $ {M}_{\text{in}} $、$ {E}_{\text{in}} $:用于计算$ {\text{e}}^{x} $,值为$ \text{float}\_\text{to}\_\text{ME(}{S}_{\text{in}}\times {\log }_{2} \text{e)} $ $ {M}_{\text{out}} $、$ {E}_{\text{out}} $:再量化因子,值为$ \text{float}\_\text{to}\_\text{ME(1/}{S}_{\text{out}}) $ 输出:$ {\boldsymbol{x}}_{\text{out}} $:Softmax的整数输出结果 计算过程:$ \text{Softmax(}\boldsymbol{x})=\frac{{\text{e}}^{\left({\boldsymbol{x}}_{\text{in}}-{\boldsymbol{x}}_{\max }\right)\times {{S}_{\text{in}}}}}{\displaystyle\sum{\text{e}}^{\left({\boldsymbol{x}}_{\text{in}}-{\boldsymbol{x}}_{\max }\right)\times {{S}_{\text{in}}}}}\times \frac{1}{{S}_{\text{out}}} $ (1) $ \Delta{\boldsymbol{x}}_{\text{in}}={\boldsymbol{x}}_{\text{in}}-{\boldsymbol{x}}_{\max } $ (2) $ {\text{e}}^{{{S}_{\text{in}}}{\times \Delta}{{\boldsymbol{x}}_{\text{in}}}}={2}^{\Delta{{\boldsymbol{x}}_{\text{in}}}\times ({{S}_{\text{in}}}\times {\log }_{2} \text{e)}}={2}^{{(\Delta}{{\boldsymbol{x}}_{\text{in}}}\times {{M}_{\text{in}}})\times {{2}^{{{E}_{\text{in}}}}}} $ (3) $ {(\Delta}{\boldsymbol{x}}_{\text{in}}\times {M}_{\text{in}})\times {2}^{{{E}_{\text{in}}}}{=\Delta}{\boldsymbol{x}}_{\text{fixed}}\times {2}^{-m}=I+r\times {2}^{-m} $ (4) $ {2}^{{(\Delta}{{\boldsymbol{x}}_{\text{in}}}\times {{M}_{\text{in}}})\times {{2}^{{{E}_{\text{in}}}}}}={2}^{I}\times {2}^{r\times {{2}^{-m}}}\text{=M}_{\text{exp}\_\text{lut}}^{r}\times {2}^{I-7} $ (5) $ {M}_{\text{sum}},{E}_{\text{sum}}{={\mathrm{int}}}\_{\text{to}}\_\text{ME(}\displaystyle\sum M_{\text{exp}\_\text{lut}}^{r}\times {2}^{I}) $ (6) $ \frac{1}{\displaystyle\sum{\text{e}}^{{{S}_{\text{in}}}{\times \Delta}{{\boldsymbol{x}}_{\text{in}}}}}=\frac{1}{\displaystyle\sum M_{\text{exp}\_\text{lut}}^{r}\times {2}^{I-7}}=\frac{1}{{M}_{\text{sum}}\times {2}^{{{E}_{\text{sum}}}-7}} $ (7) $ \text{idx=}{M}_{\text{sum}}\left[W-2:0\right],W\text{为尾数}{M}_{\text{sum}}\text{的位宽} $ (8) $ \frac{1}{\displaystyle\sum{\text{e}}^{{{S}_{\text{in}}}{\times \Delta}{{\boldsymbol{x}}_{\text{in}}}}}=M_{\text{inv}\_\text{lut}}^{\text{idx}}\times {2}^{{E_{\text{inv}\_\text{lut}}^{\text{idx}}}-{{E}_{\text{sum}}}+7} $ (9) $ {M}_{\text{final}},{E}_{\text{final}}\text{=fuse}\_\text{ME(}M_{\text{exp}\_\text{lut}}^{r},I-7,M_{\text{inv}\_\text{lut}}^{\text{idx}} $,
$E_{\text{inv}\_\text{lut}}^{\text{idx}}-{E}_{\text{sum}}+7) $(10) $ {\boldsymbol{x}}_{\text{out}}=\left({M}_{\text{out}}\times {M}_{\text{final}}\right)\ll \left({E}_{\text{final}}+{E}_{\text{out}}\right) $
下载: 导出CSV
3 全整数GELU
输入:$ {\boldsymbol{x}}_{\text{in}} $:整数输入数据 $ {M}_{\text{in}} $、$ {E}_{\text{in}} $:用于计算$ {\text{e}}^{\boldsymbol{x}} $,值为$ \text{float}\_\text{to}\_{{\mathrm{ME}}(1.702\times }{S}_{\text{in}} \times {\log }_{2} \text{e)} $ $ {M}_{\text{out}} $、$ {E}_{\text{out}} $:再量化因子,值为$ \text{float}\_\text{to}\_\text{ME(}{S}_{\text{in}}/{S}_{\text{out}}) $ 输出:$ {\boldsymbol{x}}_{\text{out}} $:GELU函数的整数输出结果 计算过程:$ \text{GELU(}\boldsymbol{x}) = {\boldsymbol{x}}_{\text{in}} \times {S}_{\text{in}} \times \dfrac{1}{{\text{e}}^{-1.702\times {{S}_{\text{in}}}{{\times \boldsymbol{x}}_{\text{in}}}}+1} \times \dfrac{1}{{S}_{\text{out}}} $ (1) $ {\text{e}}^{-1.702\times {{S}_{\text{in}}}{{\times \boldsymbol{x}}_{\text{in}}}}={2}^{-{{\boldsymbol{x}}_{\text{in}}}\times 1.702\times {{S}_{\text{in}}}\times {\log }_{2} \text{e}}= $
${2}^{-{{\boldsymbol{x}}_{\text{in}}}\times {{M}_{\text{in}}}\times {{2}^{{{E}_{\text{in}}}}}} $(2) $ -{\boldsymbol{x}}_{\text{in}}\times {M}_{\text{in}}\times {2}^{{{E}_{\text{in}}}}={\boldsymbol{x}}_{\text{fixed}}\times {2}^{\text{-m}}=I+r\times {2}^{\text{-m}} $ (3) $ {2}^{-{{\boldsymbol{x}}_{\text{in}}}\times {{M}_{\text{in}}}\times {{2}^{{{E}_{\text{in}}}}}}={2}^{I}\times {2}^{r\times {{2}^{\text{-m}}}}=M_{\text{exp}\_\text{lut}}^{r}\times {2}^{I-7} $ (4) $ {M}_{\text{D}},{E}_{\text{D}}\text{=int}\_\text{to}\_\text{ME(}M_{\text{exp}\_\text{lut}}^{r}\times {2}^{I+7}+{2}^{14}) $ (5) $ \text{idx=}{M}_{\text{D}}\left[W-2:0\right],W\text{为}{M}_{\text{D}}\text{的位宽} $ (6) $ \dfrac{1}{{\text{e}}^{-1.702\times {{S}_{\text{in}}}{{\times \boldsymbol{x}}_{\text{in}}}}+1}=\dfrac{1}{{M}_{\text{D}}\times {2}^{{{E}_{\text{D}}}-14}}=$
$M_{\text{inv}\_\text{lut}}^{\text{idx}}\times {2}^{{E_{\text{inv}\_\text{lut}}^{\text{idx}}}-{{E}_{\text{D}}}+14} $(7) $ {M}_{\text{final}},{E}_{\text{final}}\text{=fuse}\_\text{ME(}M_{\text{inv}\_\text{lut}}^{\text{idx}},E_{\text{inv}\_\text{lut}}^{\text{idx}}-{E}_{\text{D}}+14 $,
${M}_{\text{out}},{E}_{\text{out}}) $(8) $ {\boldsymbol{x}}_{\text{out}}=\left({\boldsymbol{x}}_{\text{in}}\times {M}_{\text{final}}\right)\ll {E}_{\text{final}} $
下载: 导出CSV
表 1 不同位宽下训练后量化精度结果
模型 数据精度 Top-1 Acc Top-5 Acc
ViT-smallFP32 81.43% 96.01% INT12 81.06% 95.80% INT8 81.13% 95.79% INT6 71.28% 89.54% INT4 <10% <10%
ViT-baseFP32 84.19% 97.22% INT12 83.73% 96.92% INT8 83.35% 96.89% INT6 37.45% 55.20% INT4 <10% <10%
下载: 导出CSV
表 2 不同算子全整数近似精度结果
模型 算子全整数近似 Top-1 Acc Top-5 Acc Top-1 Acc diff Top-5 Acc diff
ViT-small量化基线 81.13% 95.79% - - LN 81.04% 95.74% -0.09% -0.05% Softmax 80.17% 95.37% -0.96% -0.42% GELU 81.10% 95.87% -0.03% +0.08% ALL 80.38% 95.50% -0.75% -0.29%
ViT-base量化基线 83.35% 96.89% - - LN 83.27% 96.88% -0.02% -0.01% Softmax 82.43% 96.58% -0.92% -0.31% GELU 83.50% 96.96% +0.14% +0.07% ALL 82.42% 96.51% -0.95% -0.38%
下载: 导出CSV
表 3 与其他硬件加速器结果对比
本文方法 [24]TCAS-I’25 [25]DATE’24 [26]HPCA’23 [27]ISCA’23 [28]ISSCC’22 工艺(nm) 28 28 28 28 28 28 数据精度 INT8 INT8 INT8 INT8 INT8 INT12 频率(MHz) 500 1000 300 500 500 50-510 面积 (mm2) 3.08 1.193 2.53 3 6.03 6.82 功耗 (mW) 314.5 443.2 637 323.9 337.07 12.06-272.8 片上缓存(KB) 356 232 - 320 512 336 峰值吞吐量(GOPS) 1024 1024 614.4 512 928 522 能耗效率(TOPS/W) 3.26 2.31 0.964 1.58 2.75 1.91 面积效率(GOPS/mm2) 332.47 858.61 243 170.67 153.90 76.54
下载: 导出CSV
-
[1] VASWANI A, SHAZEER N, PARMAR N, et al. Attention is all you need[C]. Proceedings of the 31st International Conference on Neural Information Processing Systems, Long Beach, USA, 2017: 6000–6010. [2] DOSOVITSKIY A, BEYER L, KOLESNIKOV A, et al. An image is worth 16x16 words: Transformers for image recognition at scale[C]. 9th International Conference on Learning Representations, Vienna, Austria, 2021. (查阅网上资料, 未找到本条文献出版地信息, 请确认). [3] YUAN Zhihang, XUE Chenhao, CHEN Yiqi, et al. PTQ4ViT: Post-training quantization for vision transformers with twin uniform quantization[C]. 17th European Conference on Computer Vision - ECCV 2022, Tel Aviv, Israel, 2022: 191–207. doi: 10.1007/978-3-031-19775-8_12. [4] LIN Yang, ZHANG Tianyu, SUN Peiqin, et al. FQ-ViT: Post-training quantization for fully quantized vision transformer[C]. Proceedings of the Thirty-First International Joint Conference on Artificial Intelligence, Vienna, Austria, 2022: 1173–1179. [5] LI Zhikai, XIAO Junrui, YANG Lianwei, et al. RepQ-ViT: Scale reparameterization for post-training quantization of vision transformers[C]. 2023 IEEE/CVF International Conference on Computer Vision, Paris, France, 2023: 17181–17190. doi: 10.1109/ICCV51070.2023.01580. [6] 卢迪, 王振发. 脉动阵列协同层融合的卷积神经网络加速器设计[J]. 电子与信息学报, 2026, 48(3): 1280–1291. doi: 10.11999/JEIT250867.LU Di and WANG Zhenfa. Design of a CNN accelerator based on systolic array collaboration with inter-layer fusion[J]. Journal of Electronics & Information Technology, 2026, 48(3): 1280–1291. doi: 10.11999/JEIT250867. [7] 秦华标, 曹钦平. 基于FPGA的卷积神经网络硬件加速器设计[J]. 电子与信息学报, 2019, 41(11): 2599–2605. doi: 10.11999/JEIT190058.QIN Huabiao and CAO Qinping. Design of convolutional neural networks hardware acceleration based on FPGA[J]. Journal of Electronics & Information Technology, 2019, 41(11): 2599–2605. doi: 10.11999/JEIT190058. [8] NAG S, DATTA G, KUNDU S, et al. ViTA: A vision transformer inference accelerator for edge applications[C]. 2023 IEEE International Symposium on Circuits and Systems, Monterey, USA, 2023: 1–5. doi: 10.1109/ISCAS46773.2023.10181988. [9] YI C, MOH H, and HA S. Vision transformer inference on a CNN accelerator[C]. 2024 IEEE 42nd International Conference on Computer Design, Milan, Italy, 2024: 628–636. doi: 10.1109/iccd63220.2024.00101. [10] HUANG Mingqiang, LUO Junyi, DING Chenchen, et al. An integer-only and group-vector systolic accelerator for efficiently mapping vision transformer on edge[J]. IEEE Transactions on Circuits and Systems I: Regular Papers, 2023, 70(12): 5289–5301. doi: 10.1109/TCSI.2023.3312775. [11] 李天阳, 张帆, 王松, 等. 基于FPGA的卷积神经网络和视觉Transformer通用加速器[J]. 电子与信息学报, 2024, 46(6): 2663–2672. doi: 10.11999/JEIT230713.LI Tianyang, ZHANG Fan, WANG Song, et al. FPGA-based unified accelerator for convolutional neural network and vision Transformer[J]. Journal of Electronics & Information Technology, 2024, 46(6): 2663–2672. doi: 10.11999/JEIT230713. [12] SHI Huihong, CHENG Xin, MAO Wendong, et al. P2-VIT: Power-of-two post-training quantization and acceleration for fully quantized vision transformer[J]. IEEE Transactions on Very Large Scale Integration (VLSI) Systems, 2024, 32(9): 1704–1717. doi: 10.1109/TVLSI.2024.3422684. [13] LIANG Yanbiao, SHI Huihong, and WANG Zhongfeng. M2-ViT: Accelerating hybrid vision transformers with two-level mixed quantization[J]. IEEE Transactions on Very Large Scale Integration (VLSI) Systems, 2025, 33(5): 1492–1496. doi: 10.1109/TVLSI.2024.3525184. [14] 姜小波, 邓晗珂, 莫志杰, 等. 规则压缩模型和灵活架构的Transformer加速器设计[J]. 电子与信息学报, 2024, 46(3): 1079–1088. doi: 10.11999/JEIT230188.JIANG Xiaobo, DENG Hanke, MO Zhijie, et al. Design of transformer accelerator with regular compression model and flexible architecture[J]. Journal of Electronics & Information Technology, 2024, 46(3): 1079–1088. doi: 10.11999/JEIT230188. [15] TOUVRON H, CORD M, DOUZE M, et al. Training data-efficient image transformers & distillation through attention[C]. Proceedings of the 38th International Conference on Machine Learning, 2021: 10347–10357. (查阅网上资料, 未找到本条文献出版地信息, 请确认). [16] LIU Ze, LIN Yutong, CAO Yue, et al. Swin Transformer: Hierarchical vision transformer using shifted windows[C]. 2021 IEEE/CVF International Conference on Computer Vision, Montreal, Canada, 2021: 9992–10002. doi: 10.1109/ICCV48922.2021.00986. [17] DONG Peiyan, ZHUANG Jinming, YANG Zhuoping, et al. EQ-ViT: Algorithm-hardware co-design for end-to-end acceleration of real-time vision transformer inference on Versal ACAP architecture[J]. IEEE Transactions on Computer-Aided Design of Integrated Circuits and Systems, 2024, 43(11): 3949–3960. doi: 10.1109/TCAD.2024.3443692. [18] WU Zhuguanyu, ZHANG Jiayi, CHEN Jiaxin, et al. APHQ-ViT: Post-training quantization with average perturbation hessian based reconstruction for vision transformers[C]. 2025 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Nashville, USA, 2025: 9686–9695. doi: 10.1109/CVPR52734.2025.00905. [19] TAI Yushan, LIN Mingguang, and WU A Y A. TSPTQ-ViT: Two-scaled post-training quantization for vision transformer[C]. ICASSP 2023 - 2023 IEEE International Conference on Acoustics, Speech and Signal Processing, Rhodes Island, Greece, 2023: 1–5. doi: 10.1109/ICASSP49357.2023.10096817. [20] KIM S, GHOLAMI A, YAO Zhewei, et al. I-BERT: Integer-only BERT quantization[C]. Proceedings of the 38th International Conference on Machine Learning, 2021: 5506–5518. (查阅网上资料, 未找到本条文献出版地信息, 请确认). [21] LI Zhikai and GU Qingyi. I-ViT: Integer-only quantization for efficient vision transformer inference[C]. 2023 IEEE/CVF International Conference on Computer Vision, Paris, France, 2023: 17019–17029. doi: 10.1109/ICCV51070.2023.01565. [22] WU Yuchi, KUO C H, and TSUI C W. SAVE: Systolic array-based accelerator for vision transformer with efficient tiling strategy[C]. 2025 International VLSI Symposium on Technology, Systems and Applications, Hsinchu, China, 2025: 1–4. doi: 10.1109/VLSITSA64674.2025.11047111. [23] WANG Gang, CAI Siqi, LI Wenjie, et al. BSViT: A bit-serial vision transformer accelerator exploiting dynamic patch and weight bit-group quantization[J]. IEEE Transactions on Circuits and Systems I: Regular Papers, 2024, 71(9): 4064–4077. doi: 10.1109/TCSI.2024.3426653. [24] HSIUNG C L and CHANG T S. Low-power vision transformer accelerator with hardware-aware pruning and optimized dataflow[J]. IEEE Transactions on Circuits and Systems I: Regular Papers, 2026, 73(1): 360–369. doi: 10.1109/TCSI.2025.3585054. [25] CHEN Chunyun, LI Lantian, and SABRY ALY M M. ViTA: A highly efficient dataflow and architecture for vision transformers[C]. 2024 Design, Automation & Test in Europe Conference & Exhibition, Valencia, Spain, 2024: 1–6. doi: 10.23919/DATE58400.2024.10546565. [26] YOU Haoran, SUN Zhanyi, SHI Huihong, et al. ViTCoD: Vision transformer acceleration via dedicated algorithm and accelerator co-design[C]. 2023 IEEE International Symposium on High-Performance Computer Architecture, Montreal, Canada, 2023: 273–286. doi: 10.1109/HPCA56546.2023.10071027. [27] QIN Yubin, WANG Yang, DENG Dazheng, et al. FACT: FFN-attention co-optimized transformer architecture with eager correlation prediction[C]. Proceedings of the 50th Annual International Symposium on Computer Architecture, Orlando, USA, 2023: 22. doi: 10.1145/3579371.3589057. [28] WANG Yang, QIN Yubin, DENG Dazheng, et al. A 28nm 27.5TOPS/W approximate-computing-based transformer processor with asymptotic sparsity speculating and out-of-order computing[C]. 2022 IEEE International Solid-State Circuits Conference, San Francisco, USA, 2022: 1–3. doi: 10.1109/ISSCC42614.2022.9731686. -

 下载:

图(4) / 表(6)
计量
- 文章访问数: 13
- HTML全文浏览量: 1
- PDF下载量: 0
- 被引次数: 0
